Bu test neyi karşılaştırıyor?
OCR + sabit alan çıkarma hattını karşılaştırıyoruz; üretken dil modellerinin veya bütün belge işleme sistemlerinin sıralaması değil. OCR görüntüyü metne çeviriyor; aynı düzenli ifade kuralları belge numarası, tarih, satıcı, para birimi, ara toplam, KDV ve genel toplamı buluyor. İnsan düzeltmesi ve tarih noktalaması onarımı uygulanmadı.
Tesseract’ın resmî model açıklamasında fast ve best farklı hız/doğruluk hedefleri taşıyor. Burada iki deponun 4.1.0 etiketindeki Türkçe LSTM dosyaları kullanıldı. Model boyutu, her belge kümesinde daha iyi sonuç garantisi değil.
Alan doğruluğu ve işlem süresi
| Model | Doğru alan | Eksik | Yanlış | Tam doğru belge | Ortanca ms | p95 ms |
|---|---|---|---|---|---|---|
| fast | 166/168 (%98,8) | 2 | 0 | 22/24 | 156,9 | 189,4 |
| best | 159/168 (%94,6) | 4 | 5 | 18/24 | 296,0 | 345,9 |
Fast model bu sette 166 doğru alan; best model 159 doğru alan üretti. Bu, daha karmaşık gerçek belgelerde aynı sıralamanın korunacağı anlamına gelmez. Etiketin okunamaması da sayısal değerin yanlış okunması da son kullanıcı için hatadır ve ölçüme dahildir.
| Görüntü koşulu | Fast | Best |
|---|---|---|
| Temiz | 42/42 | 42/42 |
| Küçük yazı | 42/42 | 42/42 |
| 3° döndürülmüş | 40/42 | 41/42 |
| Düşük çözünürlük | 42/42 | 34/42 |
Hatalar hangi türdeydi?
Fast modelde iki döndürülmüş belgenin tarih alanı bulunamadı. Best modelde düşük çözünürlükte dört KDV alanı bulunamadı; dört tarihte nokta virgül olarak okundu ve bir sipariş numarasına ek harf geldi. Örneğin 08.10.2026 yerine 08.10,2026 çıkması, tarih sözleşmemiz tam eşleşme istediği için yanlış sayıldı.
Bu ayrım üretim tasarımını değiştirir: boş alanı, biçimi bozuk değeri ve makul görünen fakat yanlış değeri aynı kontrole bırakmayın. Toplam mutabakatı, zorunlu alan doğrulaması ve gerektiğinde insan onayı, OCR çıktısını ticari kayda dönüştürmeden önce ayrıca tasarlanır.
Test seti ve önceden belirlenen doğrular
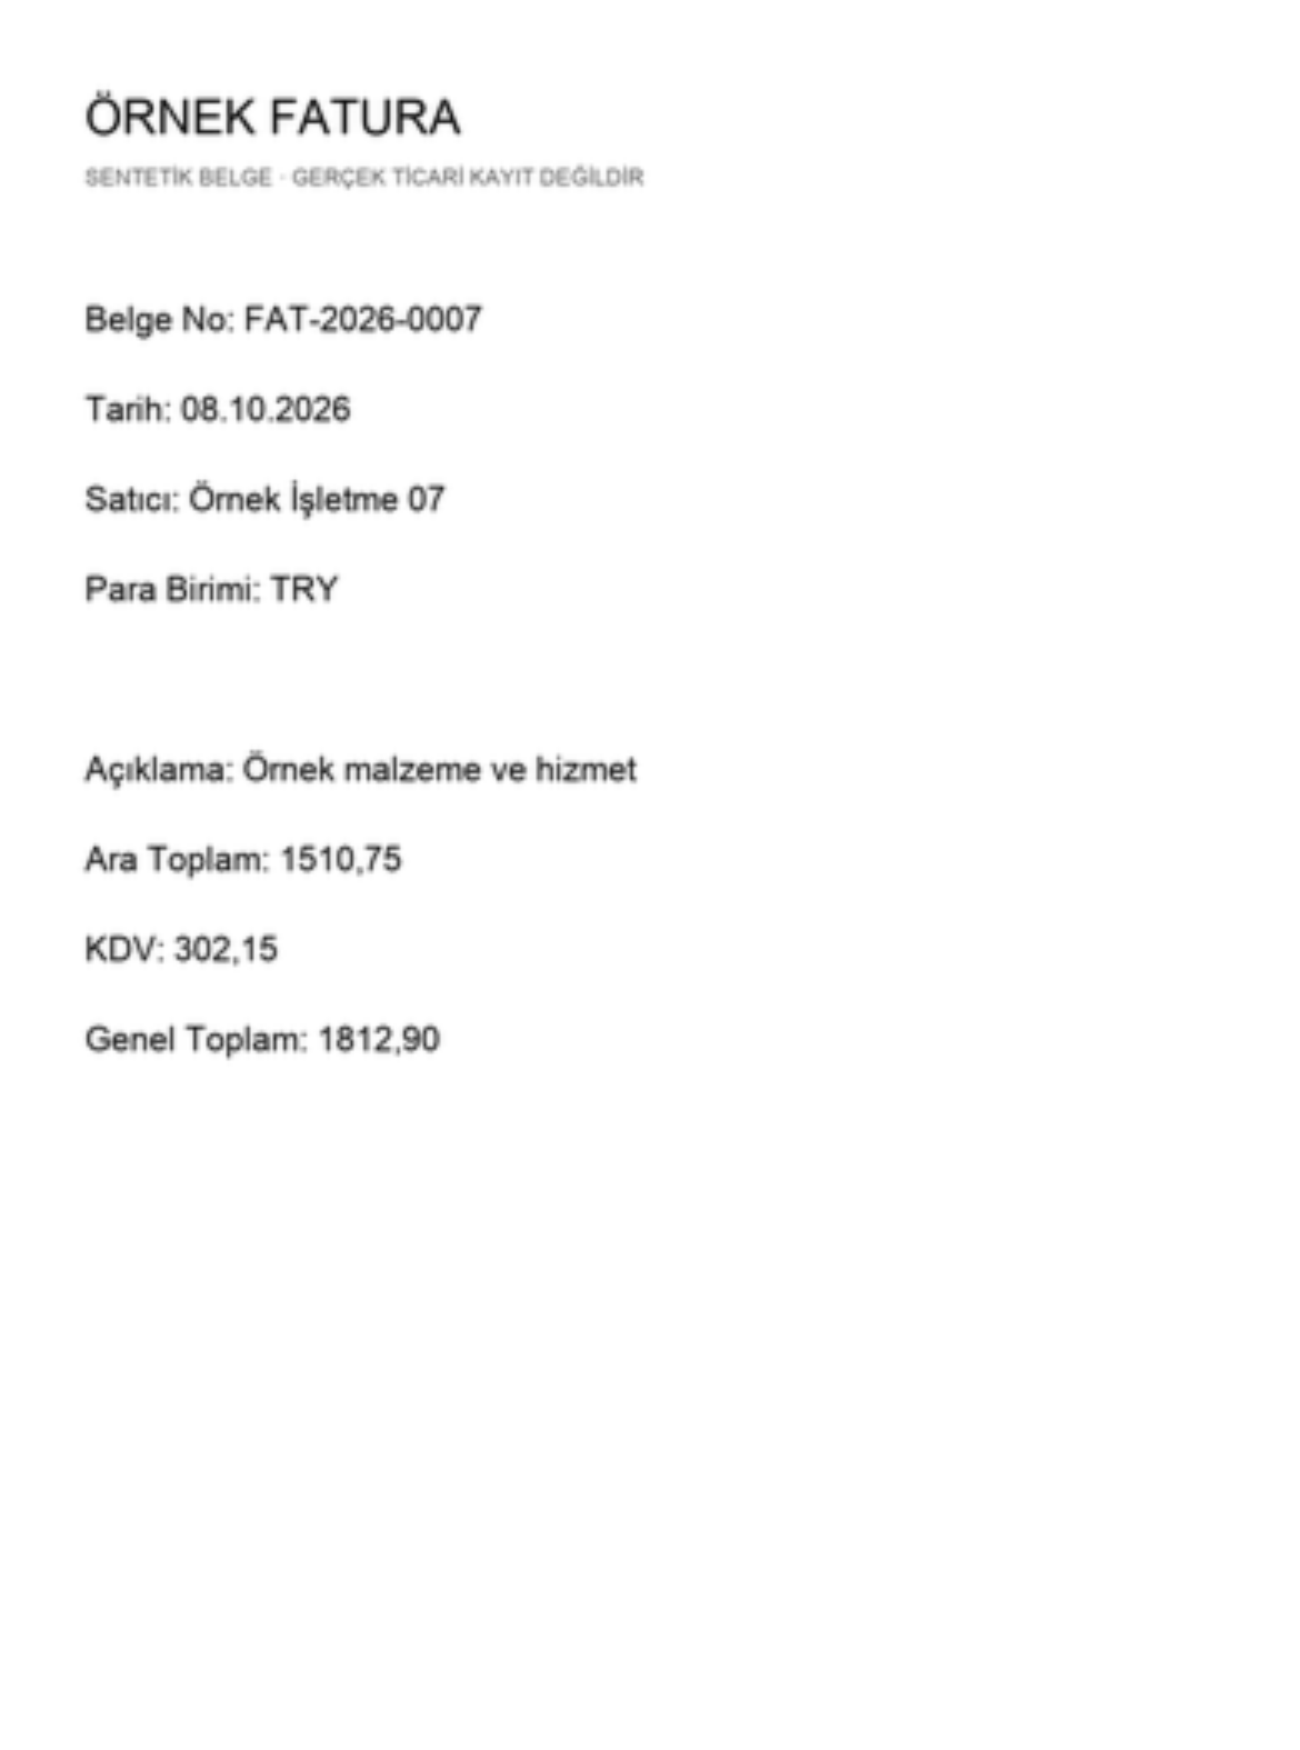
Belgeler sentetik olarak üretildi: fatura, sipariş ve teklif başlığı taşıyan üç tür; temiz, küçük yazı, 3° döndürme ve düşük çözünürlük koşulları; her hücrede iki örnek. Bunlar aynı tek sütunlu etiket şablonunun varyantlarıdır. 24 bağımsız gerçek belge düzenini temsil etmez. Yedi doğru alan, çalıştırmadan önce gold.json dosyasına yazıldı. Protokol ve görüntü özetleri sabitlendi; çalıştırıcı bunları doğruluyor.
Tekrar çalıştırma koşulları
- Ortam: Apple M4, 10 mantıksal çekirdek, 16 GB bellek, macOS/arm64, Node v24.17.0.
- Motor: Tesseract.js 6.0.1; LSTM/OEM 1, sayfa bölümleme PSM 6, satır içi boşlukları koruma açık.
- Her model önceden yüklendi. İlk belgeyle birer ölçüm dışı ısınma yapıldı; ardından 24 belgenin tamamı bir kez ölçüldü. Belge başına model sırası dönüşümlüydü. Ölçülen 48 işlemde yeniden deneme yok.
- Süre: OCR + sabit alan çıkarma. Disk okuma, model indirme/yükleme ve ısınma hariç. Yükleme ve ısınma süreleri ham kayıtta ayrı bulunur.
- Metin: Unicode NFC ve fazla boşluk normalizasyonu. Parasal değerlerde ondalık virgül noktaya çevrilip iki basamakla karşılaştırıldı. Diğer karakterler tam eşleşti. p95, sıralı 24 ölçümün 23’üncüsüdür.
İlk kurulumda paketli 7.0.0 sürümü, belge ölçümü başlamadan eksik motor sembolü hatası verdi. Ölçülen çalışma 6.0.1 ile yapıldı. Bu kurulum hatası ve bütün başarısız alanlar kayıtta tutuldu; yalnız iyi sonuçlar seçilmedi.
Belge başına maliyet ne oldu?
Dış API ücreti: her iki modelde belge başına 0 USD (15 Ekim 2026). İşlemler yerel bilgisayarda yapıldı, ücretli API çağrısı yok. Bu rakam toplam sahip olma maliyeti değildir: donanım, elektrik, geliştirme, bakım ve insan düzeltme emeği fiyatlandırılmadı. CPU süresinden varsayımsal bir tasarruf tutarı türetilmedi.
Bu sonuçtan hangi karar çıkarılabilir?
Belge akışınız sabit ve etiketliyse, yerel OCR ile kurallı çıkarma bir pilot başlangıcı olabilir. Karmaşık tablolar, el yazısı, değişken düzenler, kritik tutarlar veya belgeler arası yorum gerekiyorsa bu test karar vermeye yetmez. Kendi temsil edici belgelerinizi, izinleri ve kabul ölçütlerinizi belirleyip yeni bir karşılaştırma yapın.
Küçük sentetik örneklem; aynı şablon; tek cihaz ve tek ölçüm geçişi; arka plan işlerinin tamamen kapatılmadığı ortam: bunlar doğruluk ve süre genellemelerini sınırlar. Fiyat teklifi, SLA, güvenlik güvencesi veya Türkiye genelini temsil eden sonuç değildir.
Veri, kod ve sorumluluk
24 belgeyi, beklenen doğruları, 48 çıktıyı ve çalıştırma kodunu indirin (ZIP). Model dosyaları ve yazı tipi pakete dahil değil; resmî indirme adresleri ve SHA-256 özetleri kayıtlıdır. Sentetik veri ve sonuçlar CC0, özgün kod MIT lisansıyla paylaşılır.
Yayıncı: Codariva. Sentetik veri üretimi, kod, çalıştırma ve analiz OpenAI Codex desteğiyle hazırlandı. Sayısal toplamlar ve dosya bütünlüğü otomatik kontrollerle doğrulandı. Bir insan uzman tarafından incelenmiş olduğu iddia edilmiyor.
Değişiklik kaydı: 15 Ekim 2026 — ilk yayın, veri seti ve yöntem v1. Sonuçlar değişmeden yalnız tarih yenilenmez.
İşletmenizde bir belge pilotu planlamak
Yapay zekâ entegrasyonu kapsamı, veri erişimi ve insan onayını da içerir. Pilot senaryo ve kabul ölçütleri rehberi üzerinden uygun ilk işi seçebilir; proje briefini hazırlayabilirsiniz.