Che cosa confronta questo test?
OCR + estrazione fissa dei campi: confrontiamo questa pipeline, non stiliamo una classifica dei modelli linguistici generativi o di tutti i sistemi di elaborazione documentale. L'OCR converte l'immagine in testo; le stesse espressioni regolari individuano numero del documento, data, venditore, valuta, imponibile, IVA e totale. Non sono state applicate correzioni umane né riparazioni della punteggiatura delle date.
Nella descrizione ufficiale dei modelli Tesseract fast e best perseguono diversi obiettivi di velocità e accuratezza. Qui sono stati utilizzati, dai due repository, i file LSTM per il turco del tag 4.1.0. Le dimensioni del modello non garantiscono risultati migliori su ogni insieme di documenti.
Prima esecuzione: accuratezza dei campi e tempo di elaborazione
| Modello | Campi corretti | Mancanti | Errati | Documenti completamente corretti | Mediana ms | p95 ms |
|---|---|---|---|---|---|---|
| fast | 166/168 (%98,8) | 2 | 0 | 22/24 | 156,9 | 189,4 |
| best | 159/168 (%94,6) | 4 | 5 | 18/24 | 296,0 | 345,9 |
In questo insieme il modello fast ha prodotto 166 campi corretti, il modello best 159. Questo non significa che lo stesso ordine si manterrà su documenti reali più complessi. Sia un'etichetta non riconosciuta sia un valore numerico letto in modo errato sono errori per l'utente finale e vengono inclusi nella misurazione.
| Condizione dell'immagine | Fast | Best |
|---|---|---|
| Pulita | 42/42 | 42/42 |
| Caratteri piccoli | 42/42 | 42/42 |
| Ruotata di 3° | 40/42 | 41/42 |
| Bassa risoluzione | 42/42 | 34/42 |
Quali tipi di errori sono emersi?
Nel modello fast non è stato trovato il campo data di due documenti ruotati. Nel modello best non sono stati trovati quattro campi IVA a bassa risoluzione; in quattro date il punto è stato letto come virgola e a un numero d'ordine è stata aggiunta una lettera. Per esempio, ottenere 08.10,2026 anziché 08.10.2026 è stato considerato errato, perché la convenzione per le date richiede una corrispondenza esatta.
Questa distinzione cambia la progettazione in produzione: non affidare allo stesso controllo un campo vuoto, un valore malformato e un valore plausibile ma errato. Riconciliazione dei totali, validazione dei campi obbligatori e, quando necessario, approvazione umana devono essere progettate separatamente prima di trasformare l'output OCR in una registrazione aziendale.
| Documento / modello | Valore atteso / output OCR | Valutazione |
|---|---|---|
| FAT-rotated-1 / fast | Tarih: 06.10.2026 → Tarih; 06.10.2026 | Le cifre della data sono corrette; il punto e virgola al posto dei due punti impedisce alla regola fissa dell'etichetta di trovare il campo: mancante. |
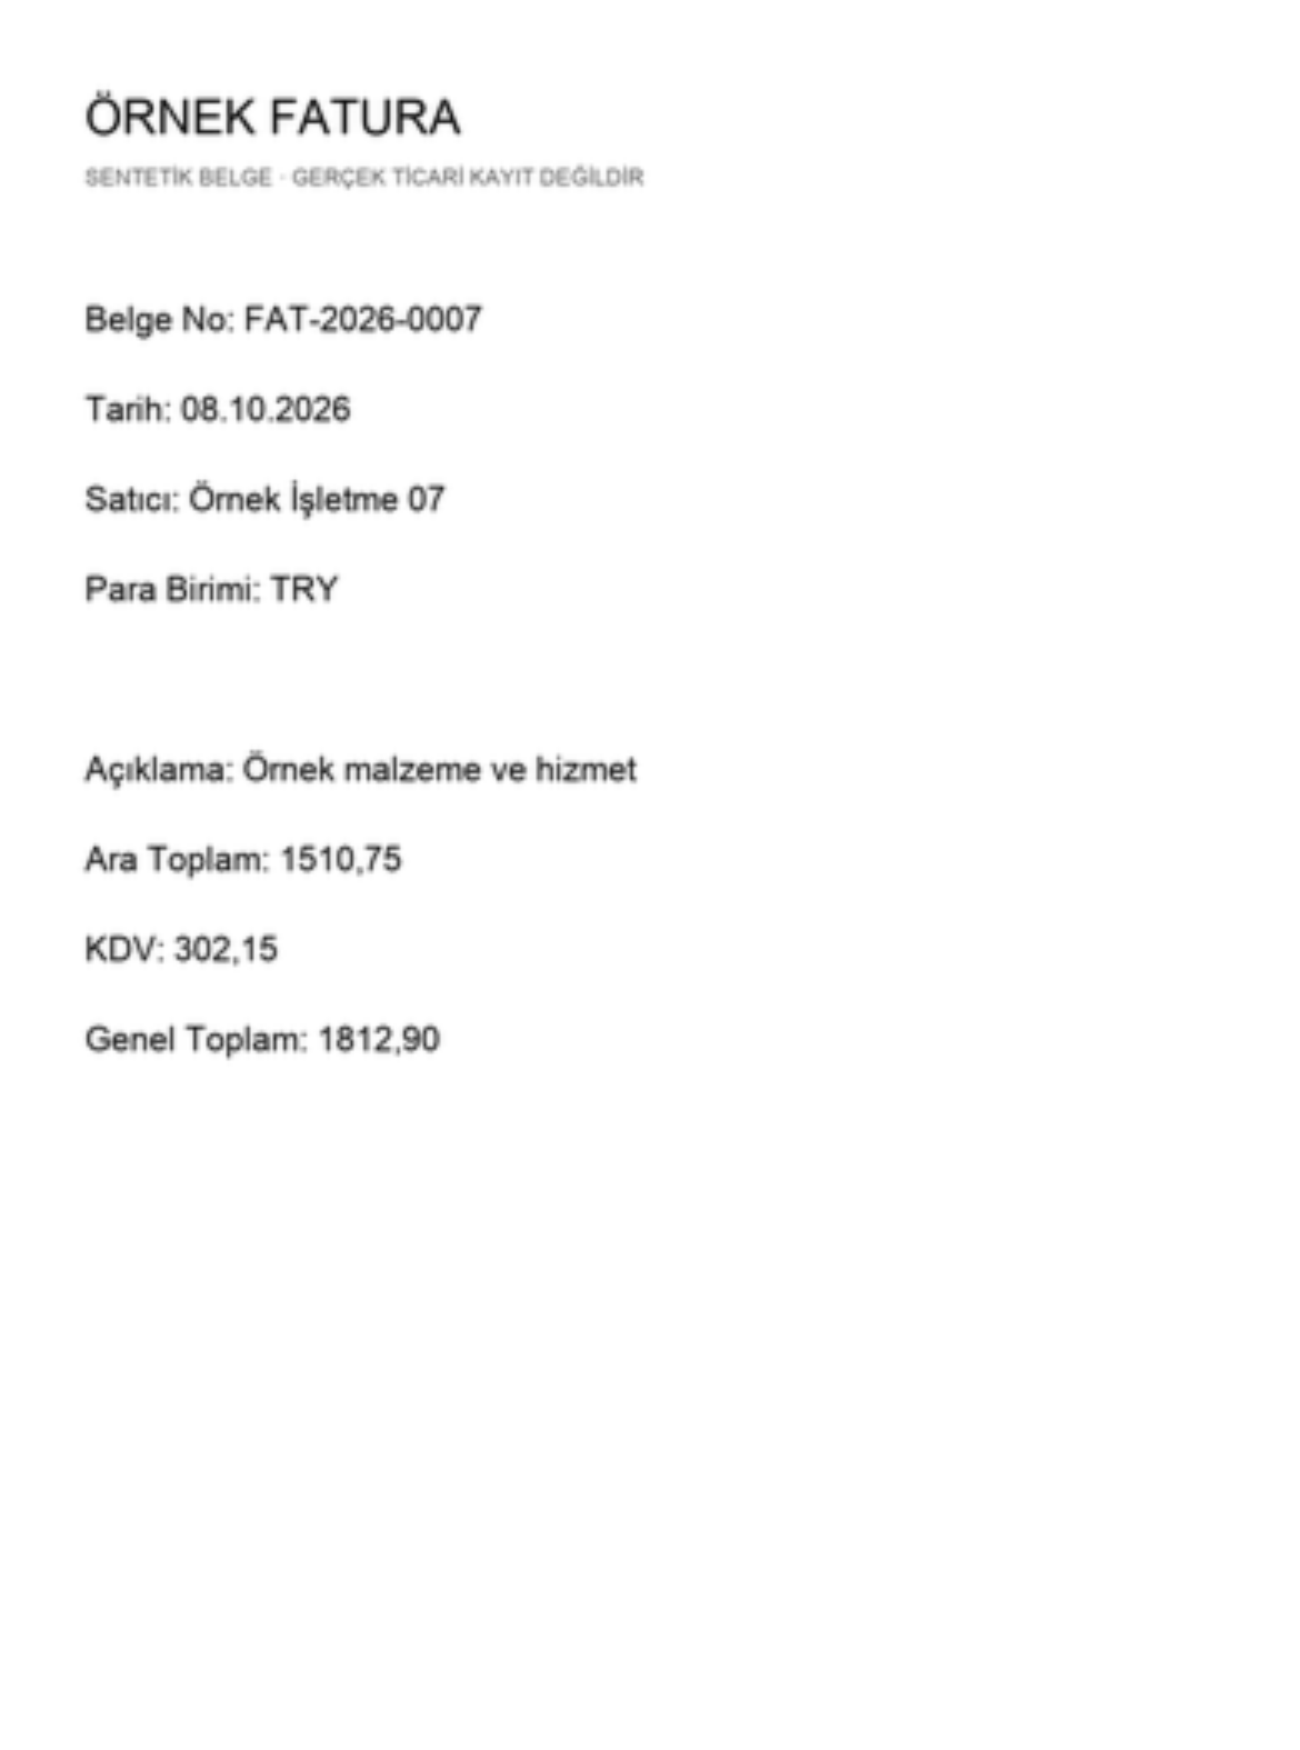
| FAT-low_resolution-1 / best | KDV: 302,15 → KOV: 302,15 | Valore corretto, etichetta errata: il campo IVA estratto è mancante. Nell'immagine compare KDV. |
| FAT-low_resolution-1 / best | 08.10.2026 → 08.10,2026 | Campo trovato; errato a causa della punteggiatura della data modificata. |
| SIP-rotated-1 / best | SIP-2026-0013 → SsIP-2026-0013 | Lettera aggiuntiva nel numero del documento: errato. L'importo 1734 ,25 nello stesso documento è invece corretto come 1734.25 grazie alla normalizzazione predefinita di spazi e decimali. |
I 168 campi attesi dei 24 documenti sono stati ricontrollati in modo indipendente tramite le formule di generazione e l'aritmetica degli importi; sono state ricalcolate le 336 valutazioni dei campi della prima esecuzione. Le immagini con errori sono state confrontate con i testi grezzi. Misuriamo la pipeline di estrazione completa, che comprende il riconoscimento delle etichette, non soltanto l'accuratezza dei caratteri OCR. Non abbiamo modificato a posteriori la tolleranza sulle etichette per migliorare il vecchio punteggio: un parser diverso richiede un esperimento separato.
Set di test e valori corretti prestabiliti
I documenti sono stati generati sinteticamente: tre tipi con intestazioni di fattura, ordine e preventivo; condizioni di immagine pulita, caratteri piccoli, rotazione di 3° e bassa risoluzione; due esempi per ogni combinazione. Sono varianti dello stesso modello di etichette a colonna singola. Non rappresentano 24 impaginazioni indipendenti di documenti reali. Prima dell'esecuzione, i sette campi corretti sono stati scritti nel file gold.json. Protocollo e hash delle immagini sono stati fissati; il programma di esecuzione li verifica.
Condizioni per ripetere l'esecuzione
- Ambiente: Apple M4, 10 core logici, 16 GB di memoria, macOS/arm64, Node v24.17.0.
- Motore: Tesseract.js 6.0.1; LSTM/OEM 1, segmentazione pagina PSM 6, conservazione degli spazi all'interno della riga attiva.
- Ogni modello è stato precaricato. Per ciascuno è stato eseguito un riscaldamento sul primo documento, escluso dalla misurazione; poi tutti i 24 documenti sono stati misurati una volta. L'ordine dei modelli si alternava per documento. Nessun nuovo tentativo nelle 48 operazioni misurate.
- Tempo: OCR + estrazione fissa dei campi. Esclusi lettura da disco, download/caricamento del modello e riscaldamento. I tempi di caricamento e riscaldamento sono riportati separatamente nel log grezzo.
- Testo: normalizzazione Unicode NFC e degli spazi in eccesso. Negli importi la virgola decimale è stata convertita in punto e i valori confrontati a due decimali. Gli altri caratteri richiedevano corrispondenza esatta. Il p95 è la 23ª delle 24 misurazioni ordinate.
Nella prima configurazione, la versione 7.0.0 del pacchetto ha restituito un errore di simbolo del motore mancante prima dell'inizio delle misurazioni sui documenti. L'esecuzione misurata è stata svolta con la 6.0.1. Questo errore di configurazione e tutti i campi non riusciti sono stati conservati nei log; non sono stati selezionati solo i risultati migliori.
Appendice tempi 1: sei ripetizioni sugli stessi documenti
Il 15 ottobre 2026, tra le 10:05 e le 10:06 UTC, sono stati eseguiti sei cicli con lo stesso dispositivo, motore, file dei modelli, 24 immagini e regole di estrazione: 144 operazioni per modello, 288 in totale. Non si tratta di 144 documenti diversi. I primi risultati v1 sono conservati integralmente sopra; i tempi seguenti provengono da un esperimento separato.
| Modello | Mediana | p95 | Mediana in prima posizione | Mediana in seconda posizione | Intervallo delle mediane dei cicli |
|---|---|---|---|---|---|
| fast | 141,1 | 153,3 | 140,5 | 141,2 | 140,0–142,5 |
| best | 272,5 | 285,4 | 272,8 | 272,3 | 271,9–273,8 |
Ogni coppia documento/modello è stata eseguita tre volte per prima e tre volte per seconda; anche l'ordine dei documenti alternava avanti e indietro. Le mediane tra prima e seconda posizione differiscono di circa lo 0,5% per fast e lo 0,2% per best: in queste condizioni l'ordine non si è invertito. Gli output dei campi sono stati identici alla v1 in tutti e sei i cicli; queste ripetizioni non costituiscono nuova evidenza di accuratezza su documenti indipendenti.
I modelli sono stati caricati e riscaldati una volta; gli stessi worker sono stati mantenuti per tutti e sei i cicli. Lettura delle immagini, verifica degli hash, caricamento, riscaldamento, valutazione e scrittura su disco sono esclusi dal tempo; OCR ed estrazione dei campi invariata sono inclusi. Il p95 è la 137ª delle 144 misurazioni secondo il metodo del rango superiore più vicino. Il pacchetto scaricabile include ciclo, ordine, testo grezzo e log del carico.
Durante la misurazione non sono state avviate altre compilazioni o esperimenti; le applicazioni già aperte sono rimaste attive. L'attività su tutti i core, OCR incluso, variava dal 16,1 al 18,9% per ciclo; la media del carico di sistema a un minuto è scesa da 12,9 a 7,1. Queste due metriche non sono equivalenti e non separano il carico in background dall'OCR. Le mediane dei cicli sono rimaste in un intervallo ristretto; tuttavia, i nuovi tempi sono inferiori alla prima misurazione notturna. Questo esperimento da solo non permette di attribuire il contributo del carico del dispositivo, della cache o delle condizioni di sessione. Non consente garanzie su avvio a freddo, uso concorrente intenso o latenza in produzione.
Qual è stato il costo per documento?
Costo API esterne: 0 USD per documento per entrambi i modelli (15 ottobre 2026). Le operazioni sono state eseguite sul computer locale, senza chiamate API a pagamento. Questo valore non è il costo totale di possesso: hardware, elettricità, sviluppo, manutenzione e lavoro di correzione umana non sono stati valorizzati. Dal tempo CPU non è stato ricavato un risparmio economico ipotetico.
Quale decisione si può ricavare da questi risultati?
Se il flusso documentale è stabile e basato su etichette, OCR locale ed estrazione a regole possono essere un punto di partenza per un pilota. Se servono tabelle complesse, scrittura a mano, impaginazioni variabili, importi critici o interpretazioni tra documenti, questo test non basta per decidere. Definisci documenti rappresentativi, autorizzazioni e criteri di accettazione, quindi svolgi un nuovo confronto.
Campione sintetico piccolo; stesso modello; un solo dispositivo; una misurazione nella v1 e sei cicli nell'appendice tempi; attività in background non interamente disattivate: questi aspetti limitano le generalizzazioni su accuratezza e tempi. Non si tratta di un preventivo, di uno SLA, di una garanzia di sicurezza né di risultati rappresentativi dell'intera Turchia.
Dati, codice e responsabilità
Scarica i 24 documenti, i valori attesi, i 48 output e il codice di esecuzione (ZIP). I file dei modelli e il font non sono inclusi; sono registrati gli URL ufficiali di download e gli hash SHA-256. Dati sintetici e risultati sono condivisi con licenza CC0, il codice originale con licenza MIT.
Editore: Codariva. Generazione dei dati sintetici, codice, esecuzione e analisi sono stati preparati con il supporto di OpenAI Codex. I totali numerici e l'integrità dei file sono stati verificati con controlli automatici. Non si dichiara una revisione da parte di un esperto umano.
Scarica i dati iniziali, l'appendice tempi di sei cicli e il controllo della valutazione (ZIP). Il primo ZIP è rimasto invariato; il nuovo pacchetto contiene i due esperimenti in cartelle separate.
Registro delle modifiche: 15 ottobre 2026 — prima pubblicazione v1; nello stesso giorno aggiunti appendice tempi 1, sei ripetizioni, esempi di errore e controllo numerico indipendente. Il dataset non è stato ampliato. Revisione svolta con Codex; nessuna dichiarazione di revisione da parte di un esperto umano.
Pianificare un progetto pilota sui documenti nella tua azienda
L'ambito dell'integrazione dell'intelligenza artificiale comprende anche accesso ai dati e approvazione umana. La guida agli scenari pilota e ai criteri di accettazione ti aiuta a scegliere la prima attività adatta; puoi preparare il brief del progetto.